szkolenia@dlatesterow.pl
 +48 574 110 335
 Polska, 44-102 Pyskowice, ul. Poziomkowa 3, NIP 627-255-46-55


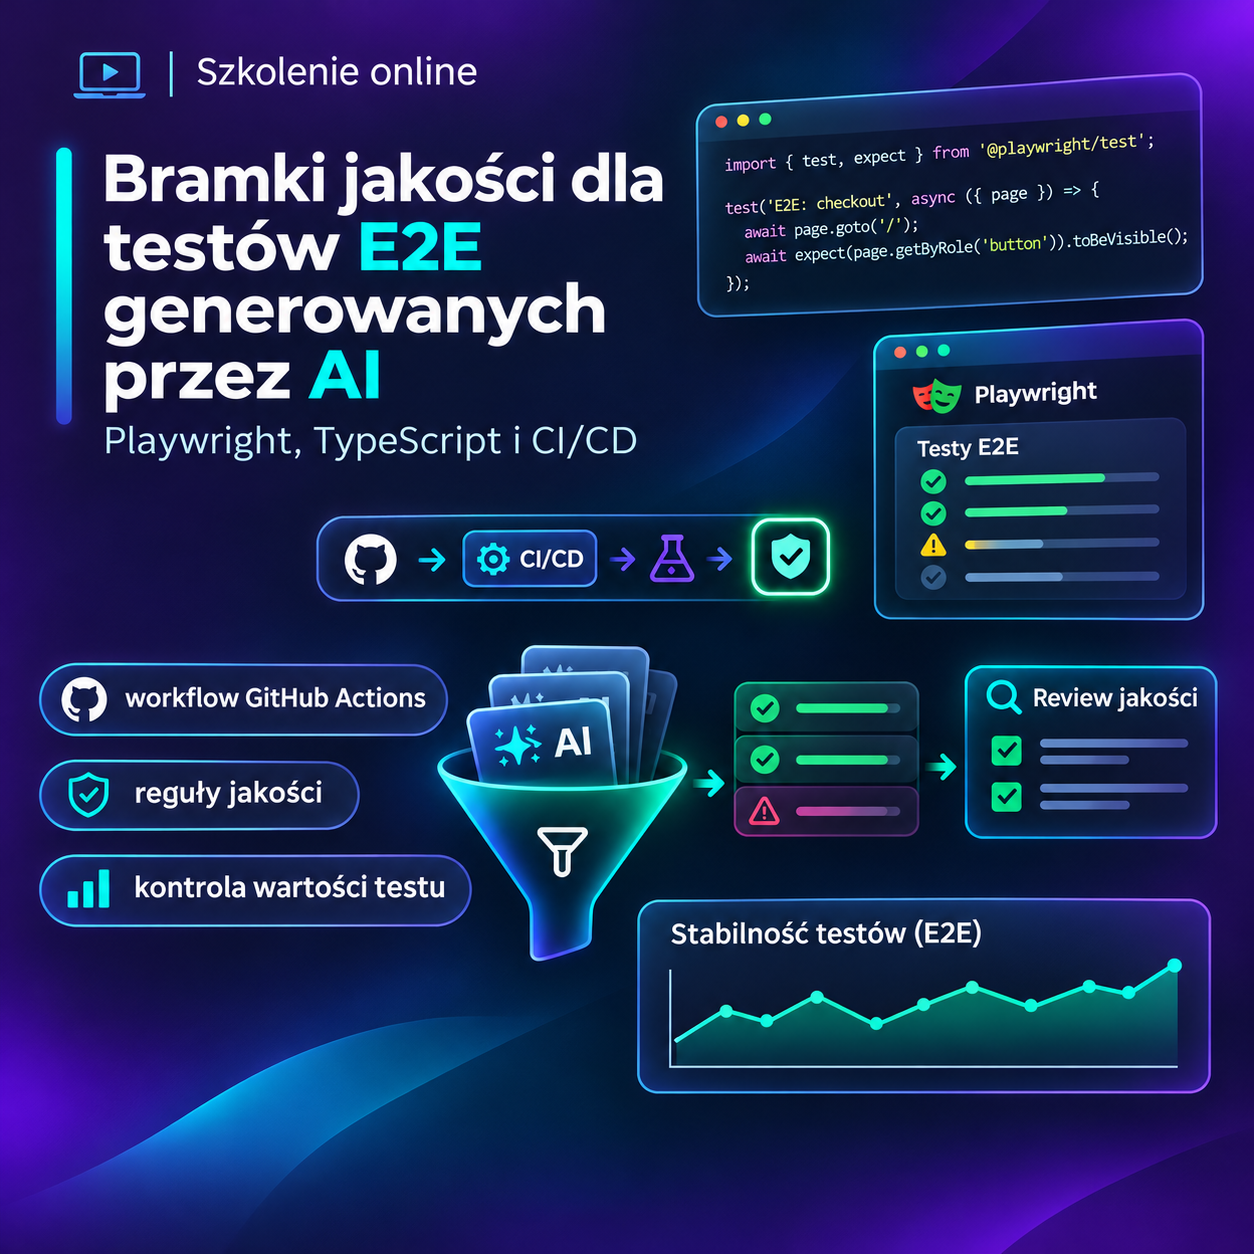
AI napisze Ci test w kilkanaście sekund. Problem w tym, że równie szybko napisze test, który zawsze przechodzi i niczego nie sprawdza. Na tym szkoleniu budujesz pipeline, który zatrzymuje takie testy, zanim trafią do repozytorium: bramki techniczne, reguły dla złych praktyk, kontrolę wartości testu i stabilności. Pracujemy na Playwright z TypeScript/JavaScript oraz narzędziach AI, z których korzystasz na co dzień (GitHub Copilot, Claude Code, Codex, Cursor).
Zespoły mają bramki jakości dla kodu aplikacji: typowanie, linter, code review, testy w CI. Dla testów E2E zwykle nie ma żadnych. Dopóki testy pisał człowiek, dało się to jakoś przeżyć. Kiedy testy zaczyna generować AI, ich liczba rośnie szybciej, niż ktokolwiek jest w stanie je przeczytać.
Zielony pipeline mówi wtedy tylko tyle, że testy przechodzą. Nie mówi, czy cokolwiek sprawdzają.
To szkolenie jest praktyczne i techniczne. Pokazuje, jak w realnym projekcie wymusić, żeby każdy nowy test (napisany przez człowieka albo przez AI) był poprawny, stabilny i sprawdzał coś wartościowego. Pracujemy na przygotowanym repozytorium i aplikacji demo, a gotowy workflow zabierasz do swojego projektu.
Dla kogo jest to szkolenie?
- Dla testerów automatyzujących i QA Engineerów, którzy piszą testy w Playwright z pomocą AI.
- Dla SDET-ów i programistów odpowiedzialnych za testy E2E i pipeline CI.
- Dla QA Leadów i Test Managerów, którzy chcą wprowadzić w zespole standard pracy z testami generowanymi przez AI.
- Dla zespołów, które zaczęły generować testy z AI i widzą, że rośnie koszt ich utrzymania.
Co zyskasz dzięki szkoleniu?
- Działający workflow GitHub Actions z bramkami jakości dla testów E2E, gotowy do przeniesienia do Twojego projektu.
- Własne reguły ESLint wykrywające złe praktyki w testach Playwright.
- Zestaw zasad dla agentów AI w repozytorium, dzięki którym AI od początku pisze testy zgodne z Waszym standardem.
- Metodę sprawdzania, czy test potrafi nie przejść z właściwego powodu.
- Sposób na powiązanie testów z wymaganiami i macierz pokrycia AC ↔ test.
- Kolejność wdrażania bramek w zespole, od najtańszych do najbardziej zaawansowanych.
Agenda
Czas trwania: 1 dzień, 7 godzin szkoleniowych
Forma: online, na żywo, z ćwiczeniami na przygotowanym repozytorium
1. Wprowadzenie: czym są bramki jakości dla testów E2E
- Bramki jakości w kodzie aplikacji i dlaczego testy E2E zwykle ich nie mają.
- Co się zmienia, gdy testy zaczyna pisać AI: więcej testów, szybciej, mniej czytane przez człowieka.
- Trzy pytania o każdy test: czy kod jest poprawny, czy test jest stabilny, czy test coś sprawdza.
- Typowe słabości testów generowanych przez AI: słabe asercje, kruche selektory, sztywne oczekiwanie, testy zielone bez względu na stan aplikacji.
- Mapa bramek, które zbudujemy w trakcie dnia, i kolejność ich wdrażania w zespole.
2. Podstawowe bramki techniczne
- TypeScript (tsc –noEmit), ESLint, Prettier.
- playwright test –list jako kontrola, czy Playwright widzi wszystkie testy.
- Konfiguracja Playwright pod CI: forbidOnly, retries, trace.
3. Automatyczne wykrywanie złych praktyk
- Własne reguły ESLint dla testów Playwright.
- Blokowanie wzorców: waitForTimeout, test.only, force: true, XPath, page.$(), puste catch, testy bez asercji.
- Kiedy toBeTruthy() jest za słabą asercją.
4. Selektory jako bramka jakości
- Hierarchia lokatorów: getByRole, getByLabel, getByText, getByTestId, CSS tylko wyjątkowo.
- Wykrywanie kruchych selektorów (nth(), łańcuchy CSS, XPath).
- Zasady dla agenta AI w repozytorium: jak sprawić, żeby model nie brał pierwszego selektora, który akurat działa.
5. Kontrola wartości testu
- Obowiązkowa asercja biznesowa w każdym teście.
- Adnotacje i tagi Playwright łączące test z wymaganiem (AC).
- Macierz pokrycia AC ↔ scenariusz ↔ test generowana z pomocą AI i zatwierdzana przez człowieka.
6. Red → Green: test testu
- Zasada: nowy test musi nie przechodzić, gdy funkcjonalność jest zepsuta, i przechodzić po poprawnej zmianie.
- Jak wbudować tę kontrolę w codzienną pracę z AI i w review PR.
- Co oznacza test, który przechodzi w obu przypadkach.
- Kontrolowane mutacje jako kierunek rozbudowy.
7. Stabilność i izolacja danych
- Bramka stabilności: –repeat-each, wiele workerów, pełna równoległość.
- Dlaczego retry nie może ukrywać flaky testów i jak je raportować osobno.
- Własne dane dla każdego testu, unikalne identyfikatory, brak zależności między testami.
8. Pipeline w GitHub Actions
- Składamy wszystkie bramki w jeden workflow uruchamiany na każdym PR.
- Co uruchamiać na PR, a co po merge lub w nocy.
- Raporty, trace i artefakty dla nieudanych testów.
9. Warsztat praktyczny
- AI generuje testy do aplikacji demo.
- Przepuszczamy je przez bramki, analizujemy, co zostało zatrzymane i dlaczego.
- Poprawiamy testy i zasady dla agenta, aż pipeline przejdzie z właściwych powodów.
10. Co dalej i podsumowanie
- AI jako recenzent zakresu zmian w PR, limity czasowe testów, audyt artefaktów.
- Plan wdrożenia bramek w zespole krok po kroku.
- Pytania i dyskusja.
Co będziesz umieć po szkoleniu?
- Zbudować pipeline, który blokuje słabe testy E2E, niezależnie od tego, kto je napisał.
- Napisać własne reguły jakości dla testów Playwright.
- Ocenić, czy test wygenerowany przez AI sprawdza coś wartościowego.
- Udowodnić, że test potrafi nie przejść z właściwego powodu.
- Wykrywać flaky testy, zanim trafią do głównej gałęzi.
- Wprowadzić w zespole standard pracy z testami generowanymi przez AI.
Uczciwie o zakresie: bramki chronią repozytorium przed słabymi testami, ale nie zastępują myślenia testera. Pełny zestaw bramek to projekt na tygodnie. Na szkoleniu budujesz fundament i działający pipeline, który rozbudujesz u siebie.
Przed szkoleniem konieczne jest:
- Podstawowa znajomość Playwright oraz JavaScript lub TypeScript.
- Zainstalowany Node.js (wersja LTS), Git i edytor kodu (np. VS Code).
- Konto na GitHubie (do uruchomienia workflow GitHub Actions).
- Dostęp do narzędzia AI do pracy z kodem: GitHub Copilot, Claude Code, Codex albo Cursor. Wersje darmowe mają limity, które mogą przeszkadzać w części praktycznej.
Repozytorium z aplikacją demo i instrukcją przygotowania środowiska otrzymasz przed szkoleniem.
Prowadzący
Radosław Wasik, QA Tech Lead, od 2018 roku w branży IT. Prowadzi transformację działu QA w kierunku AI: szkoli zespoły, wdraża autorskie rozwiązania AI wspierające testowanie i zarządza zespołami QA na co dzień. Specjalizuje się w testach automatycznych (Playwright, TypeScript) i praktycznym zastosowaniu AI w pracy testera.
Po godzinach dzieli się wiedzą z testerami na rwasik.pl: prowadzi cotygodniowy newsletter, publikuje praktyczne treści o Playwright i AI w testowaniu na Instagramie i LinkedInie. Jest autorem e-booka “Testowanie to coś więcej niż klikanie” i warsztatów, w tym “Tester z AI”. Prelegent konferencji testerskich, m.in. Testing Ground i Test Warez.
Szkolenie dla Twojego zespołu?
Nie pasuje Ci termin albo chcesz przeprowadzić szkolenie dla całego zespołu, na Waszym repozytorium i Waszych standardach? Napisz: szkolenia@dlatesterow.pl